El resumen del día
Informe 2026-10-07: matemáticas históricas, modelos gigantes abiertos y herramientas prácticas para equipos y detección
Si trabajas con IA, hoy debes decidir si tu pila técnica se alineará con quien define la investigación matemática, con quien regala acceso a fundadores o con quien abre pesos a gran escala; cada opción tiene consecuencias directas en talento, costes y riesgo reputacional.
Consecuencia práctica inicial
La consecuencia más relevante para quien diseña productos y operaciones de IA es que las decisiones de hoy sobre proveedores y modelos no son neutras: elegir una API u hospedar pesos propios puede condicionarte a años en talento, facturación y exposiciones legales, y las noticias de hoy muestran tres rutas muy distintas —investigación de frontera, captación temprana de startups y apertura de modelos— que obligan a priorizar recursos ya mismo.
OpenAI y la publicación masiva de resultados matemáticos
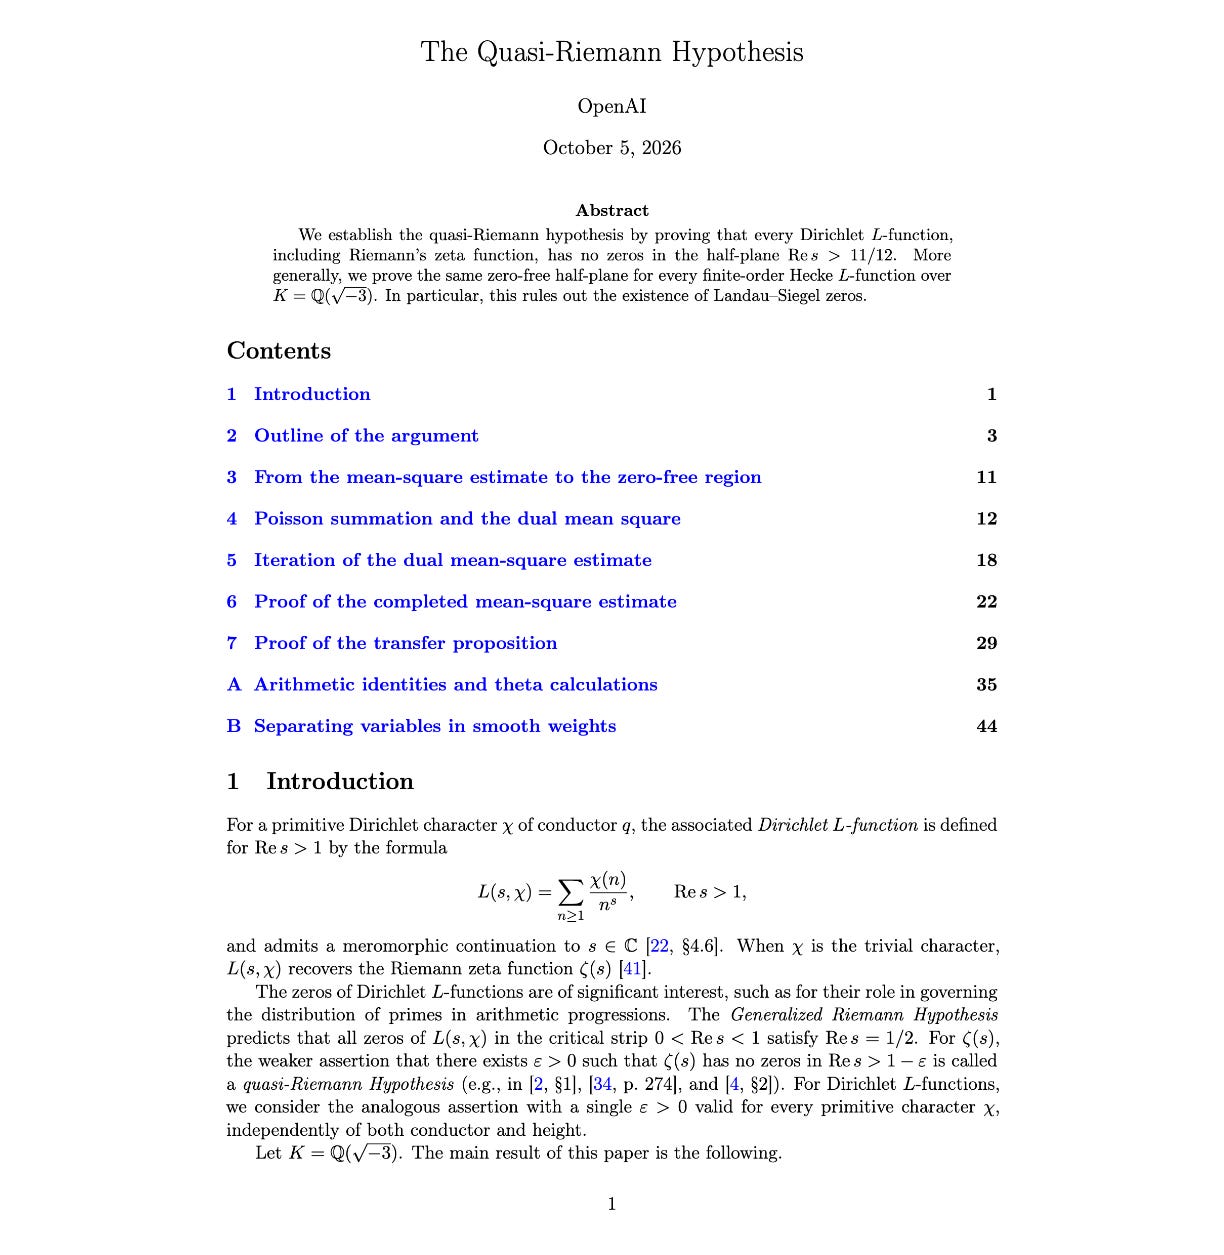
OpenAI ha hecho público un paquete amplio de trabajos matemáticos procedentes de un modelo interno bautizado Navier‑Stokes, publicando un repositorio y un post que, según la compañía, contiene 722 manuscritos que incluyen soluciones a decenas de problemas considerados entre los 500 más relevantes, con un resultado destacado etiquetado como la Cuasi‑Hipótesis de Riemann, descrita en algunos círculos como un hallazgo entre un premio Fields y el mayor resultado en teoría de números en dos siglos; esto importa porque si las máquinas empiezan a producir matemáticas de alto nivel reproducibles y verificables, los equipos de investigación y las empresas que dependen de avances teóricos (criptografía, optimización, verificación formal) deben replantear presupuestos de I+D, procesos de revisión y relaciones con talento humano experto, y además preguntarse cómo integrar, validar y auditar resultados generados en segundos por modelos frente al trabajo tradicional de laboratorio, aquí el anuncio y el repositorio están disponibles en Latent Space: https://www.latent.space/p/ainews-quasi-riemann-hypothesis-openai.
Anthropic captura fundadores con Claude Founder House
Anthropic lanza Claude Founder House, un programa que ofrece un año gratuito de Claude Team más 1.000 dólares en créditos API para equipos en fase de idea o prototipo, una jugada deliberada para anclar a nuevos proyectos al ecosistema Claude y así capturar decisiones de stack y dependencia a largo plazo; esto no es solo marketing: proporciona herramientas colaborativas y contextos largos que facilitan construir MVPs complejos sin coste inicial, lo que obliga a rivals y a responsables de compras de plataformas a replantear las políticas de onboarding y acuerdos de vendor lock‑in, más detalles en WWWhat's New IA: https://wwwhatsnew.com/2026/10/07/anthropic-claude-founder-house-startups-gratis-2026/.
Mistral abre pesos con Large 4 «Le Chonk»
Mistral presentó Large 4 «Le Chonk», un modelo de alrededor de un billón de parámetros cuyo rasgo operativo más relevante es el compromiso de liberar los pesos en pocas semanas, una decisión que reaviva el debate europeo sobre apertura frente a control y que también cambia el cálculo de ingeniería para quienes prefieren traer modelos on‑premise u optimizar costos de inferencia; la hoja de ruta y contexto financiero están en WWWhat's New IA: https://wwwhatsnew.com/2026/10/07/mistral-large-4-le-chonk-billon-parametros-open-weights-2026/.
Modelos del mundo y orquestación de agentes
En paralelo, startups como Mirror Particle plantean que los LLM fallan cuando se necesita predecir decisiones humanas concretas y proponen world models del comportamiento para casos como publicidad o políticas públicas, mientras que iniciativas como Stacklok buscan trasladar la fiabilidad de agentes desde el escritorio a la nube mediante controles al estilo Kubernetes; ambas tendencias señalan que la arquitectura operacional y la calidad de datos comportamentales serán tan críticas como la potencia del modelo base, más información en TechCrunch y Latent Space.
SynthID de Google se vuelve más accesible
Finalmente, Google ha mejorado su detector SynthID y ha lanzado un sitio público para verificar marcas invisibles en imágenes, vídeo y audio generados por IA, y ahora el sistema acepta las marcas de socios externos, lo que facilita a equipos de confianza y moderación comprobar autenticidad sin depender de consultas a modelos; la herramienta es relevante para riesgos regulatorios y flujos de trabajo de contenido: https://arstechnica.com/ai/2026/10/google-rolls-out-improved-synthid-ai-content-detector-now-available-globally/.
¿Vas a rediseñar tu stack para depender de investigación propietaria, atraer fundadores con créditos y equipos colaborativos, o ejecutar pesos abiertos y controlar todo internamente?
Analizado hoy...
Estas son las noticias analizadas hoy, a las que puedes acceder para conocer más detalle.
Anthropic lanza Claude Founder House: un año de Claude Team gratis y 1.000 dólares en créditos para startups
Mistral lanza Large 4 «Le Chonk»: un billón de parámetros y pesos abiertos en tres semanas
Mirror Particle construye modelos del mundo del comportamiento humano porque los LLM no son suficientes para predecir lo que hace la gente
¿Puede un arnés nativo en la nube hacer que los agentes sean fiables más allá del escritorio?